6.0002 · Introduction to Computational Thinking and Data Science · lección 1
Introducción y problemas de optimización
6.0002 es la segunda mitad de 6.00: menos sobre aprender a programar y más sobre modelos computacionales, o sea, cómo usar la computación para entender el mundo. Esta primera clase presenta el curso, define qué es un modelo de optimización y lo ataca con un caso concreto, el problema de la mochila (knapsack), resuelto con un algoritmo goloso (greedy). De paso aparecen las funciones lambda de Python.
Lectura de la clase: sección 12.1 (optimización) y sección 5.4 (funciones lambda) del libro de Guttag, Introduction to Computation and Programming Using Python.
1. El curso
| 6.0001 | 6.0002 | |
|---|---|---|
| Foco | Aprender a programar | Resolver problemas; introducción a ciencia de datos |
| Problem sets | Más centrados en la programación | Algo más fáciles: el peso está en el problema |
| Clases | Más abstractas y más rápidas |
Prerrequisitos: programación orientada a objetos en Python (3.5), nociones de complejidad computacional y algunos algoritmos simples. Con 6.0001 alcanza.
Evaluación: problem sets de programación, finger exercises (ejercicios cortos de un solo concepto; si llevan más de 15 minutos, algo anda mal), lecturas del libro y un examen final sobre todo eso.
“¿Cómo llego al Carnegie Hall?” — “Practicando, practicando, practicando.” Es la única forma de aprender a programar.
2. Modelos computacionales
Un modelo es un dispositivo experimental que sirve para:
- entender algo que ya pasó (explicar un fenómeno), o
- predecir algo que todavía no pasó.
Ejemplo: un modelo climático que explica cómo cambió el clima a lo largo de milenios, y otro, parecido, que predice cómo va a cambiar. La ciencia se está mudando del laboratorio a la computadora: la experimentación tradicional sigue siendo importante, pero ahora se complementa con computación.
El curso cubre tres tipos de modelos:
- Modelos de optimización ← esta clase
- Modelos estadísticos
- Modelos de simulación
3. ¿Qué es un modelo de optimización?
Tiene dos partes:
- Función objetivo: lo que se quiere maximizar o minimizar. Ej.: minimizar el tiempo de viaje de Nueva York a Boston.
- Restricciones (posiblemente ninguna): condiciones que toda solución tiene que cumplir. Ej.: no gastar más de USD 100; llegar antes de las 17:00.
Las dos partes no se tratan igual: la función objetivo ordena las soluciones; las restricciones eliminan soluciones. En el ejemplo, el avión es lo más rápido pero cuesta más de USD 100, y el micro es barato pero llega tarde: queda manejar.
Los usamos todo el tiempo: Waze, buscadores de vuelos y hoteles, etc.
4. El problema de la mochila
Un ladrón entra a una casa con una mochila que aguanta un peso limitado. Hay más cosas de las que puede llevar: ¿cuáles se lleva y cuáles deja?
- Objetivo: maximizar el valor de lo que se lleva.
- Restricción: que entre en la mochila.
Casi nunca es una mochila física. El ejemplo que usa la clase: tengo un presupuesto de calorías y quiero elegir la comida que más me guste sin pasarme.
Dos variantes
| Variante | Qué se puede tomar | Dificultad |
|---|---|---|
| 0/1 | Cada objeto entero o nada (el lingote de oro completo). | Difícil: cada decisión condiciona las siguientes. |
| Continua o fraccionaria | Pedazos de un objeto (el oro hecho polvo). | Fácil: se resuelve con un algoritmo goloso. |
La continua es trivial. Con pilas de oro, plata y pasas: lleno la mochila de oro hasta que se acabe el oro o el espacio; si queda lugar, sigo con plata; después, pasas. Siempre tomo lo mejor primero.
La 0/1 no. Si con 1500 calorías de presupuesto tomo algo de 1200 y todo lo demás tiene más de 300, ya no puedo agregar nada. Elegir un objeto restringe lo que se puede elegir después.
5. Formalización del problema 0/1
- Cada objeto es un par \(\langle \text{valor}, \text{peso} \rangle\).
- La mochila admite un peso total de a lo sumo \(w\).
- Un vector \(I\) de longitud \(n\) representa los objetos disponibles.
- Un vector \(V\) de longitud \(n\) indica qué se toma: \(V[i] = 1\) si el objeto \(I[i]\) se toma y \(V[i] = 0\) si no.
\(V\) es un número binario de \(n\) bits que codifica un subconjunto de objetos. El problema queda:
\[\text{Encontrar } V \text{ que maximice} \quad \sum_{i=0}^{n-1} V[i] \cdot I[i].\text{valor}\] \[\text{sujeto a} \quad \sum_{i=0}^{n-1} V[i] \cdot I[i].\text{peso} \le w\]Multiplicar por \(V[i] \in \{0, 1\}\) es el truco: un objeto no tomado aporta \(0\) a la suma; uno tomado aporta su valor (o su peso) completo.
Esta es la forma habitual de trabajar con problemas de optimización: partir de una descripción informal y traducirla a una representación matemática.
6. Fuerza bruta
- Enumerar todas las combinaciones de objetos, es decir, todos los subconjuntos: el conjunto potencia (incluye el vacío y el conjunto completo).
- Descartar las combinaciones cuyo peso supera \(w\).
- De las que quedan, elegir cualquiera de valor máximo (puede haber empates).
Siempre da la respuesta correcta, porque revisa todas las posibilidades. El problema es el tamaño: hay tantos \(V\) posibles como números binarios de \(n\) bits, o sea \(2^n\).
\[n = 100 \implies 2^{100} = 1\,267\,650\,600\,228\,229\,401\,496\,703\,205\,376\]Y en la práctica \(n\) suele ser del orden de mil o un millón.
¿Hay algo mejor?
No. El problema de la mochila 0/1 es inherentemente exponencial: no existe un algoritmo exacto cuyo peor caso no sea exponencial en la cantidad de objetos. Pero hay soluciones aproximadas muy buenas.
7. Algoritmo goloso
mientras la mochila no esté llena
    poner el "mejor" objeto disponible en la mochila
La pregunta clave es qué significa “mejor”:
- el más valioso,
- el más barato (en este caso, el de menos calorías), o
- el de mayor densidad: valor por unidad de peso.
Implementación
Primero una abstracción de datos para cada comida:
class Food(object):
    def __init__(self, n, v, w):
        self.name = n
        self.value = v
        self.calories = w
    def getValue(self):
        return self.value
    def getCost(self):
        return self.calories
    def density(self):
        return self.getValue()/self.getCost()
    def __str__(self):
        return self.name + ': <' + str(self.value)\
                 + ', ' + str(self.calories) + '>'

def buildMenu(names, values, calories):
    menu = []
    for i in range(len(values)):
        menu.append(Food(names[i], values[i], calories[i]))
    return menu
Después un único goloso “flexible”: el criterio de “mejor” entra como parámetro, keyFunction.
def greedy(items, maxCost, keyFunction):
    """Assumes items a list, maxCost >= 0,
         keyFunction maps elements of items to numbers"""
    itemsCopy = sorted(items, key = keyFunction,
                       reverse = True)
    result = []
    totalValue, totalCost = 0.0, 0.0
    for i in range(len(itemsCopy)):
        if (totalCost+itemsCopy[i].getCost()) <= maxCost:
            result.append(itemsCopy[i])
            totalCost += itemsCopy[i].getCost()
            totalValue += itemsCopy[i].getValue()
    return (result, totalValue)
Detalles que vale la pena notar:
sortedy no.sort():sorteddevuelve una copia, así que la lista que se recibe como parámetro no se modifica. Evitar efectos secundarios sobre los parámetros es buena higiene.reverse = True: ordena de mejor a peor.- No corta en el primer objeto que no entra. Puede quedar poco espacio y el siguiente no entrar, pero más abajo en la lista quizás haya uno que sí. Por eso recorre todos.
Complejidad
| Paso | Costo |
|---|---|
Ordenar (sorted) |
\(O(n \log n)\) |
| Recorrer la lista una vez | \(O(n)\) |
| Total | \(O(n \log n)\) |
Es muy eficiente: con un millón de objetos se resuelve sin problemas.
Nota. En clase se dice que timsort es una variante de quicksort. En realidad es un híbrido de merge sort e insertion sort. Lo que importa sí es correcto: su peor caso es \(O(n \log n)\).
Probando los tres criterios
def testGreedy(items, constraint, keyFunction):
    taken, val = greedy(items, constraint, keyFunction)
    print('Total value of items taken =', val)
    for item in taken:
        print('   ', item)

def testGreedys(foods, maxUnits):
    testGreedy(foods, maxUnits, Food.getValue)              # por valor
    testGreedy(foods, maxUnits, lambda x: 1/Food.getCost(x)) # por costo
    testGreedy(foods, maxUnits, Food.density)               # por densidad
Food.getValuese pasa sin paréntesis: se pasa la función, no el resultado de llamarla.- Para “más barato primero” no sirve ordenar por
getCostde mayor a menor. Se ordena por \(1/\text{costo}\), así el de menos calorías queda arriba.
Qué es exactamente keyFunction
Es el criterio de “mejor”, pero aplicado a cada ítem por separado: recibe un Food y devuelve un número. greedy ordena de mayor a menor según ese número y prueba los ítems en ese orden.
| Criterio | keyFunction |
Qué ítem va primero |
|---|---|---|
| Por valor | Food.getValue |
el que más me gusta |
| Por calorías | lambda x: 1/Food.getCost(x) |
el de menos calorías |
| Por densidad | Food.density |
el que da más valor por caloría |
Cualquier criterio sirve si devuelve un número por ítem. Por ejemplo, lambda x: x.getValue()**2 / x.getCost() es una densidad que le da más peso al valor.
Lo que no se puede expresar así: criterios sobre la selección completa, como “llevar la mayor cantidad de ítems”. Ningún número mide cuánta “cantidad” aporta una pizza sola. Igual se consigue de forma indirecta: tomar primero los de menos calorías es justamente lo que hace entrar más ítems en el presupuesto.
Lo que keyFunction no cambia:
- El objetivo.
greedysiempre sumagetValue(): se maximiza el valor total, sea cual sea el criterio. El criterio solo cambia el orden en que se prueban los ítems. - La restricción. Siempre se controla con
getCost()contramaxCost.
8. Funciones lambda
Crean funciones anónimas (sin nombre):
lambda <id1>, <id2>, ..., <idn>: <expresión>
Devuelven una función de \(n\) argumentos que evalúa la expresión y retorna el resultado. Es como un def escrito en línea.
En lambda x: 1/Food.getCost(x), x tiene que ser de tipo Food: getCost es un método de la clase Food, y Food.getCost(x) equivale a x.getCost(), con x en el lugar de self.
Consejo de Guttag. Se pueden escribir
lambdacomplicadísimas. No lo hagas. Si no entra en una línea, usádef: es más fácil de depurar. Para una línea,lambdaes ideal.
9. Resultados
El menú (valor = cuánto me gusta, en “puntos de felicidad”):
| Comida | wine | beer | pizza | burger | fries | cola | apple | donut |
|---|---|---|---|---|---|---|---|---|
| Valor | 89 | 90 | 95 | 100 | 90 | 79 | 50 | 10 |
| Calorías | 123 | 154 | 258 | 354 | 365 | 150 | 95 | 195 |
La tabla de la diapositiva 20 muestra otros valores (pizza 30, burger 50, apple 90). Los de arriba son los del código, que son los que producen los resultados. Además, la lista
namesdel código incluye'cake', pero comobuildMenuitera sobrelen(values)(8 elementos), cake se descarta en silencio.
Con 750 calorías:
| Criterio | Valor total | Elige |
|---|---|---|
| Por valor | 284 | burger, pizza, wine |
| Por costo | 318 | apple, wine, cola, beer, donut |
| Por densidad | 318 | wine, beer, cola, apple, donut |
Costo y densidad eligen el mismo menú; solo cambia el orden en que lo encuentran, porque ordenan distinto.
Con 1000 calorías:
| Criterio | Valor total | Elige |
|---|---|---|
| Por valor | 424 | burger, pizza, beer, wine, apple |
| Por costo | 413 | apple, wine, cola, beer, donut, pizza |
| Por densidad | 413 | wine, beer, cola, apple, pizza, donut |
Resultado. Ningún criterio gana siempre. Con 750 calorías la densidad es mejor que el valor; con 1000, al revés.
10. ¿Por qué respuestas distintas?
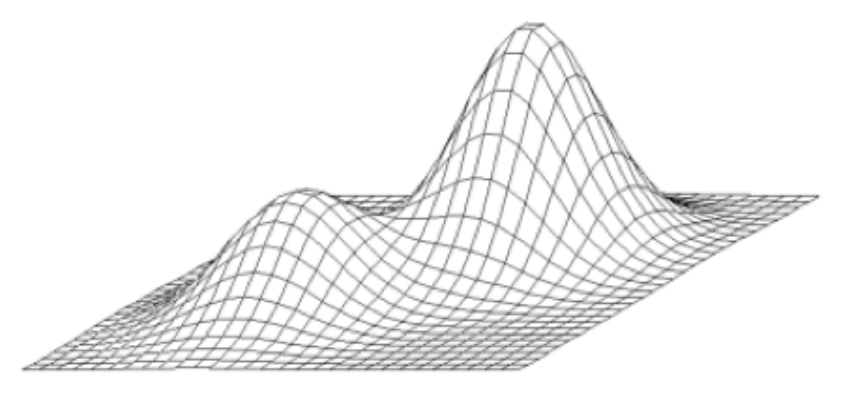
Un algoritmo goloso toma una secuencia de decisiones localmente óptimas, y eso no garantiza una solución globalmente óptima.
La imagen clásica es el ascenso de colinas (hill climbing): quiero llegar al punto más alto y la regla es “si puedo subir, subo; si no, me quedo”. Según para dónde arranque, termino en la cima de la colina chica, un máximo local, sin forma de llegar al máximo global, porque para eso tendría que bajar primero y el goloso nunca retrocede.
Pros y contras del goloso
| Pros | Contras |
|---|---|
| Fácil de implementar | No siempre da la mejor solución |
| Computacionalmente eficiente, \(O(n \log n)\) | Ni siquiera se sabe qué tan buena es la aproximación |
Resumen
| Qué | Resultado |
|---|---|
| Modelo de optimización | Función objetivo (max/min) + restricciones |
| Mochila 0/1 | Maximizar \(\sum V[i]\, I[i].\text{valor}\) con \(\sum V[i]\, I[i].\text{peso} \le w\), \(V[i] \in \{0,1\}\) |
| Mochila continua | Fácil: goloso por densidad |
| Fuerza bruta | Correcta pero \(O(2^n)\): recorre el conjunto potencia |
| Mochila 0/1 en general | Inherentemente exponencial |
| Goloso | \(O(n \log n)\); la calidad depende de qué se entiende por “mejor” |
lambda |
Función anónima de una sola expresión |
Glosario
- Modelo computacional: dispositivo experimental, en la computadora, para explicar el pasado o predecir el futuro.
- Función objetivo: la magnitud que se quiere maximizar o minimizar.
- Restricción: condición que descarta soluciones.
- Mochila 0/1: cada objeto se toma entero o no se toma.
- Mochila continua (fraccionaria): se pueden tomar fracciones de objetos.
- Conjunto potencia: el conjunto de todos los subconjuntos de un conjunto; tiene \(2^n\) elementos.
- Problema inherentemente exponencial: no admite un algoritmo exacto con peor caso subexponencial.
- Algoritmo goloso (greedy): en cada paso toma la mejor opción disponible, sin volver atrás. También se lo llama voraz o ávido.
keyFunction: función que le asigna a cada ítem un número; define qué ítem es “mejor” para el algoritmo goloso.- Óptimo local / global: el mejor punto en un entorno / el mejor de todos.
- Densidad: valor dividido por costo.
lambda: forma de definir una función anónima en una línea.